
Esto es de esas cosas que tenía apuntadas desde hace tiempo. En un trabajo anterior lo teníamos en la lista de mejoras pendientes, de las que sabes que están ahí, que algún día habrá que hacer, y que siempre pierden contra la siguiente funcionalidad urgente. Ya no estoy allí, pero la curiosidad se quedó, así que me he puesto a estudiarlo con calma para tenerlo claro la próxima vez que me toque decidir cómo identificar los registros de un sistema.
La pregunta de fondo es muy simple: ¿qué uso como identificador de mis registros? Y resulta que las dos respuestas de siempre tienen pegas.
El problema de las opciones clásicas
El autoincremental (IDENTITY en SQL Server, SERIAL en Postgres) es cómodo y rápido, pero:
- El id lo genera la base de datos, así que no lo conoces hasta que has insertado. Si quieres crear un objeto, lanzar un evento del dominio con su id y guardarlo todo después, no puedes.
- Expone información: si tu pedido es el 1043 y mañana el 1087, cualquiera sabe cuántos pedidos haces al día. Y adivinar ids ajenos es tan fácil como sumar uno.
- Juntar datos de varias bases de datos es un dolor, porque todas tienen su registro 1, su registro 2...
El GUID aleatorio (UUID versión 4) resuelve todo eso: se genera en cualquier sitio, no revela nada y no choca nunca. Pero tiene un problema menos visible y bastante serio: es aleatorio. Si lo usas como clave primaria con un índice agrupado, cada inserción cae en un sitio cualquiera del índice, en vez de al final. La base de datos tiene que andar partiendo páginas para hacer hueco, el índice se fragmenta y crece más de la cuenta, y las inserciones se van volviendo más lentas según crece la tabla.
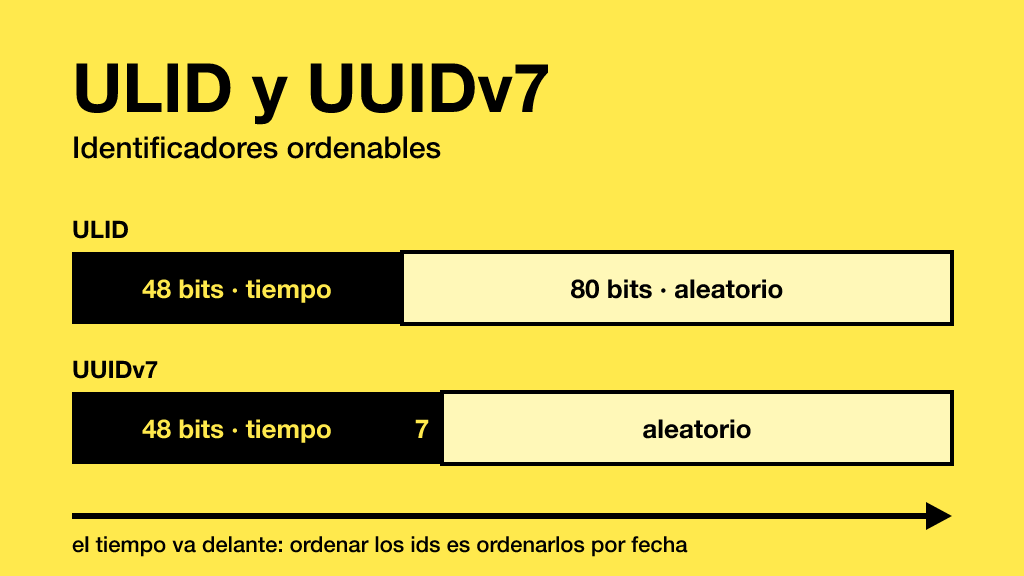
Lo ideal sería algo que se genere en cualquier sitio, como un GUID, pero que vaya siempre creciendo, como un autoincremental. Y eso es justo lo que son ULID y UUIDv7.
ULID
ULID (Universally Unique Lexicographically Sortable Identifier) es un identificador de 128 bits, igual que un GUID, pero con truco: los primeros 48 bits son la fecha y hora en milisegundos, y los 80 restantes son aleatorios. Se representa como una cadena de 26 caracteres:
01ARZ3NDEKTSV4RRFFQ69G5FAV
|--------||--------------|
  tiempo     aleatorio
Como el tiempo va delante, los ULID generados más tarde son siempre "mayores" que los anteriores, y ordenarlos alfabéticamente es lo mismo que ordenarlos por fecha de creación. Además:
- Usan la codificación Base32 de Crockford, que evita letras que se confunden (no hay
I,L,OniU), así que son más cortos y fáciles de leer que un GUID, y no llevan guiones ni caracteres raros para ir en una URL. - Si generas varios en el mismo milisegundo, la especificación contempla un modo monótono que incrementa la parte aleatoria, para que sigan saliendo ordenados.
Usarlos es trivial. En JavaScript:
import { ulid } from 'ulid';

const id = ulid(); // 01J8Z3K2M4N5P6Q7R8S9T0V1W2
Y en .NET, con el paquete Ulid:
var id = Ulid.NewUlid();
Guid comoGuid = id.ToGuid();
Y en Java, con la librería ulid-creator. Para generar varios en el mismo milisegundo y que salgan ordenados, usa la variante monótona:
import com.github.f4b6a3.ulid.Ulid;
import com.github.f4b6a3.ulid.UlidCreator;
import java.util.UUID;

Ulid id = UlidCreator.getMonotonicUlid();   // 01M508H53K8JKHQ6450QSQ4JEE
String texto = id.toString();
UUID comoUuid = id.toUuid();                // para guardarlo en una columna uuid
UUIDv7: lo mismo, pero estándar
El problema de ULID es que es una especificación de la comunidad, no un estándar. Y en 2024 llegó el RFC 9562, que actualiza la definición de los UUID e incluye una versión nueva, la 7, que hace prácticamente lo mismo: 48 bits de timestamp en milisegundos delante, y el resto aleatorio.
0192a3b4-c5d6-7e8f-9a0b-1c2d3e4f5a6b
              ^
          versión 7
La gran ventaja de UUIDv7 es que es un UUID. Encaja en cualquier columna de tipo uuid o uniqueidentifier, en cualquier librería y en cualquier API que ya trabaje con GUIDs, sin conversiones. Y el soporte nativo ya está llegando a todas partes:
// .NET 9 en adelante, sin paquetes
var id = Guid.CreateVersion7();
-- PostgreSQL 18 en adelante
SELECT uuidv7();
// Node, con el paquete uuid
import { v7 } from 'uuid';
const id = v7();
En Java, el JDK 26 ya trae un método para construir un UUIDv7 a partir de una fecha, pero no garantiza el orden entre dos ids generados en el mismo milisegundo. Si lo necesitas, y en versiones anteriores del JDK, la librería uuid-creator se encarga de eso:
import com.github.f4b6a3.uuid.UuidCreator;
import java.util.UUID;

// JDK 26 en adelante, sin librerías
UUID id = UUID.ofEpochMillis(System.currentTimeMillis());

// Con uuid-creator (com.github.f4b6a3:uuid-creator)
UUID id = UuidCreator.getTimeOrderedEpoch();
Los dos devuelven un java.util.UUID de versión 7, así que encajan con cualquier columna uuid sin conversiones.
Cuidado con SQL Server
Aquí viene el detalle que, de haber hecho aquel cambio en su momento, nos habría costado un buen disgusto, porque allí trabajábamos con SQL Server. SQL Server no ordena los uniqueidentifier como esperarías, byte a byte de izquierda a derecha: los compara empezando por el último grupo del GUID. Así que, aunque un UUIDv7 lleve el tiempo delante, para SQL Server ese tiempo no es lo que manda al ordenar, y el índice se sigue fragmentando igual que con un GUID aleatorio.
Las opciones para no caer en la trampa:
- Guardar el identificador como
binary(16)en vez deuniqueidentifier, que sí se ordena byte a byte. - Si el id solo tiene que ser único y el orden te da igual, mantener un índice agrupado sobre otra columna (una fecha de creación o un autoincremental interno) y usar el UUIDv7 como clave de negocio con un índice no agrupado.
- Y ojo también con .NET, que al convertir un
Guida bytes invierte el orden de los primeros grupos. Si guardas en binario, asegúrate de que la conversión respeta el orden big-endian.
En Postgres, en cambio, el tipo uuid se ordena byte a byte, y UUIDv7 funciona tal cual sin hacer nada especial.
¿Cuál elegir?
A día de hoy, para un sistema nuevo, me iría a UUIDv7: es estándar, encaja con todo lo que ya trabaja con GUIDs y el soporte nativo no para de crecer. ULID sigue teniendo sentido si el identificador se ve mucho (en URLs, en pantallas, en logs que alguien va a leer), porque es más corto y más amable a la vista. Y no son incompatibles: los dos son 128 bits con el tiempo delante, así que se puede pasar de uno a otro sin perder nada.
Un último detalle a tener en cuenta: los dos llevan dentro la fecha de creación, y cualquiera puede sacarla. Normalmente da igual, pero si el momento en que se creó algo es información sensible, mejor no exponer ese id hacia fuera.
Para cerrar
Aquella mejora se quedó en la lista, y probablemente siga ahí. Cambiar el tipo de identificador en un sistema que ya está en producción no se hace un viernes por la tarde. Pero al menos ahora tengo claro por dónde iría la próxima vez que empiece algo desde cero: UUIDv7 generado en la aplicación, y mirando con lupa cómo ordena los identificadores la base de datos que toque. Porque, como demuestra lo de SQL Server, que el identificador sea ordenable no sirve de nada si quien lo guarda no lo ordena como tú esperas.