
En el equipo en el que estuve teníamos una aplicación web con un buen puñado de tests e2e en Cypress: altas de usuarios, compras, reservas. Probar lo que se ve en pantalla es la parte fácil. Lo que no es tan fácil es todo lo que pasa alrededor: ¿qué dejó el test en la base de datos?, ¿cómo vuelvo a empezar con el escenario limpio?, ¿de dónde saco un dato que la UI nunca me enseña?
Lo resolvimos dándole a Cypress acceso directo a la base de datos, SQL Server en nuestro caso. Nada de endpoints de pruebas montados a propósito en la aplicación (mi forma de verlo: es código que existe solo para los tests pero viaja con la aplicación a producción, y alguien tiene que acordarse de protegerlo). Te cuento cómo lo montamos y para qué lo usábamos. Los nombres de tablas y columnas de los ejemplos son inventados; lo que importa es la idea.
Por qué hace falta cy.task
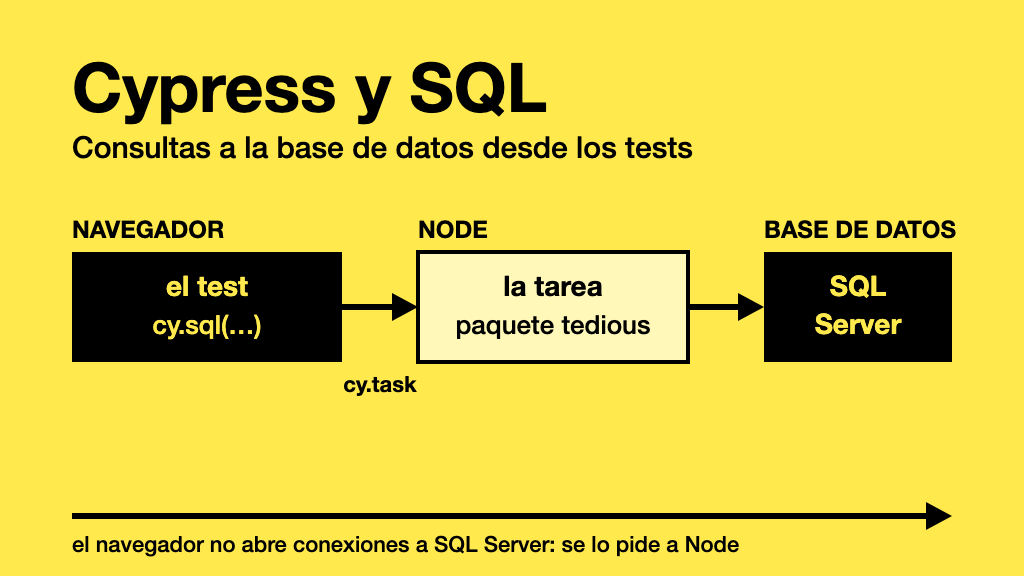
El código de los tests de Cypress se ejecuta en el navegador, y desde el navegador no puedes abrir una conexión a SQL Server. La pieza que lo hace posible es cy.task: un mecanismo para que el test le pida a Node (el proceso de Cypress que corre por debajo) que ejecute algo por él y le devuelva el resultado.
El esquema es: el test llama a cy.sql, un comando propio que por dentro llama a cy.task, que se ejecuta en Node, que es quien de verdad habla con SQL Server.
¿Por qué tedious y no mssql?
Nosotros usábamos tedious, que es el driver de SQL Server para Node. Si buscas cómo conectar Node con SQL Server, lo más probable es que acabes en mssql, que es más cómodo (pool de conexiones, promesas, parámetros con tipos). Pero mssql por dentro usa tedious, así que lo que hay debajo es lo mismo.
Para lo que necesitábamos, que era una conexión y consultas sueltas desde los tests, no hacía falta un pool. A cambio, tedious es de más bajo nivel y te toca envolverlo tú, con eventos en lugar de promesas. Son unas cuarenta líneas. Si no te apetece escribirlas, mssql es una opción perfectamente válida.
npm install --save-dev tedious
Una configuración por entorno, sin la contraseña
Cada entorno tiene su propia base de datos. En cypress/config/ teníamos un JSON por entorno (en los ejemplos uso dev y staging) con la URL base y los datos de conexión. Todo menos la contraseña: esa no se escribe en el JSON, se lee de una variable de entorno.
{
    "baseUrl": "http://app.dev.example.com",
    "env": {
        "id": "dev",
        "db": {
            "server": "localhost",
            "database": "AppDb",
            "user": "cypress",
            "encrypt": true
        }
    }
}
El entorno se elige al lanzar Cypress con --env configFile=staging (sin nada, usa dev), y la contraseña se pasa desde fuera:
DB_PASSWORD='<password>' npx cypress run --env configFile=staging
En local la exportas en tu terminal, y en CI sale de los secretos del job. Dos detalles:
- Tiene que ser una variable de entorno del proceso de Node (
process.env), no una de Cypress (CYPRESS_...o--env). Las de Cypress son accesibles desde el navegador, y la contraseña no tiene por qué llegar ahí. - Que sea el fichero del entorno quien diga a qué base de datos se conecta es lo que evita ejecutar un
DELETEdonde no toca.
La tarea en Node
Usábamos Cypress 9, así que la tarea se registra en cypress/plugins/index.js (de Cypress 10 en adelante se hace en setupNodeEvents, dentro de cypress.config.js). He simplificado el código que teníamos y le he añadido parámetros, que es lo que yo habría querido desde el principio:
// cypress/plugins/database/sqlClient.js
const { Connection, Request, TYPES } = require('tedious');

let connectionPromise; // una única conexión durante toda la ejecución

function connect(db) {
    if (connectionPromise) return connectionPromise;

    connectionPromise = new Promise((resolve, reject) => {
        const connection = new Connection({
            server: db.server,
            options: { database: db.database, encrypt: db.encrypt },
            authentication: {
                type: 'default',
                options: { userName: db.user, password: db.password }
            }
        });
        connection.on('connect', error => error ? reject(error) : resolve(connection));
        connection.on('end', () => { connectionPromise = undefined; }); // si se cae, la próxima vuelve a conectar
        connection.connect();
    }).catch(error => {
        connectionPromise = undefined; // si falla la conexión, que el siguiente intento pueda reintentar
        throw error;
    });

    return connectionPromise;
}

function typeOf(value) {
    if (typeof value === 'number') return Number.isInteger(value) ? TYPES.Int : TYPES.Float;
    if (typeof value === 'boolean') return TYPES.Bit;
    return TYPES.NVarChar;
}

function executeSql(connection, query, params = {}) {
    return new Promise((resolve, reject) => {
        const rows = [];
        const request = new Request(query, error => error ? reject(error) : resolve(rows));

        Object.entries(params).forEach(([name, value]) => {
            request.addParameter(name, typeOf(value), value);
        });

        request.on('row', columns => {
            const row = {};
            columns.forEach(column => {
                // Id -> id, Email -> email: así en los tests escribimos rows[0].id
                const name = column.metadata.colName;
                row[name.charAt(0).toLowerCase() + name.slice(1)] = column.value;
            });
            rows.push(row);
        });

        connection.execSql(request);
    });
}

module.exports = { connect, executeSql };
// cypress/plugins/index.js
const fs = require('fs-extra');
const path = require('path');
const { connect, executeSql } = require('./database/sqlClient');

module.exports = (on, config) => {
    const file = config.env.configFile || 'dev';
    const configFile = fs.readJsonSync(path.resolve('./cypress', 'config', `${file}.json`));

    // La contraseña viene del entorno del proceso, nunca del JSON ni de config.env
    if (!process.env.DB_PASSWORD) {
        throw new Error('Falta la variable de entorno DB_PASSWORD');
    }
    const db = { ...configFile.env.db, password: process.env.DB_PASSWORD };

    on('task', {
        async sql({ query, params }) {
            const connection = await connect(db);
            return executeSql(connection, query, params);
        }
    });

    return configFile; // así la baseUrl y el env del entorno llegan a Cypress
};
Unos cuantos detalles:
- Si falta
DB_PASSWORD, Cypress ni arranca, y con un mensaje que dice qué falta. Mejor eso que un fallo de login de SQL Server a mitad de la ejecución. - Una tarea de Cypress no puede devolver
undefined, así que siempre tiene que devolver algo. Con esta forma unDELETEdevuelve un array vacío y unSELECTdevuelve las filas. - Si la consulta falla, la tarea lanza el error y el test falla con el mensaje de SQL Server. En nuestra versión original capturábamos el error y lo devolvíamos como resultado, y eso tiene su trampa: el test sigue como si nada y el fallo aparece tres pasos después, en otro sitio. No lo repetiría.
- Lo que se guarda es la promesa de la conexión, no la conexión: así, si dos consultas llegan a la vez, comparten la misma conexión en lugar de abrir una cada una. Si la conexión falla o se cae, se descarta y la siguiente consulta lo vuelve a intentar.
- Los nombres de columna salen con la primera letra en minúscula (
Idpasa aid), para escribirrows[0].id. Y si haces unSELECT COUNT(*), ponle un alias (COUNT(*) AS total): sin nombre de columna, SQL Server no tiene con qué rellenar la clave. - Los valores van como parámetros (
@email), no concatenados en la query. En un entorno de tests el riesgo de inyección SQL es bajo, pero en cuanto un email de prueba lleva una comilla simple, la query concatenada revienta. En nuestra versión original sí concatenábamos.
El comando cy.sql
En cypress/support/commands.js añadimos el recubrimiento, que no es más que una fachada bonita sobre la tarea:
Cypress.Commands.add('sql', (query, params = {}) => {
    return cy.task('sql', { query, params });
});
Parece poca cosa, pero es lo que hace que los tests se lean como lo que son, y no como un montón de fontanería. El nombre de la tarea y su forma de llamarla quedan en un único sitio.
Cómo lo usábamos desde los tests
Los tests no tenían las consultas sueltas. Cada dominio tenía un fichero de funciones compartidas, con la consulta dentro y un nombre que dice qué hace. Así en el test se lee customerHelper.deleteRegisteredCustomer(email) y no un DELETE suelto.
Limpiar lo que ha creado el test. El caso más frecuente. Cada alta deja filas en varias tablas, y el test las borra al terminar:
function deleteRegisteredCustomer(email) {
    // Primero los hijos y luego los padres, o las claves foráneas no te dejarán borrar
    cy.sql(`
        DELETE FROM Memberships
        WHERE CustomerId IN (SELECT Id FROM Customers WHERE Email = @email)`, { email });
    cy.sql('DELETE FROM Customers WHERE Email = @email', { email });
}
Nosotros lo hacíamos en dos pasos: primero buscábamos el id de la fila padre, que no sale en ninguna pantalla, y luego borrábamos los hijos con ese id. Con una subconsulta como la de arriba te ahorras el viaje.
Conocer datos del catálogo. Algunos tests necesitaban el id de un elemento que depende de cómo esté cargado el entorno. En lugar de dejarlo fijo en el test, lo preguntamos:
function getCatalogItemId(sku, warehouse) {
    return cy
        .sql('SELECT Id FROM CatalogItems WHERE Sku = @sku AND Warehouse = @warehouse', { sku, warehouse })
        .then(rows => rows.length >= 1 ? rows[0].id : null);
}
Dejar el escenario en un estado conocido. Este es el que más me gustó. Hay cosas que el propio test consume: las plazas de una reserva, el stock de un producto... Si no lo reseteas, el test pasa la primera vez y falla la segunda, porque ya no queda sitio. Antes de cada test restablecíamos el estado con un UPDATE:
function resetSlotAvailability(slotId) {
    cy.sql('UPDATE ServiceSlots SET Capacity = @capacity, Booked = 0 WHERE Id = @slotId',
        { capacity: 10, slotId });
}
Esto es justo lo que no puedes hacer desde la UI: nadie va a entrar a un backoffice a vaciar las reservas antes de cada ejecución.
Y así quedaba un test
Para que se vea todo junto, este es el esquema de uno de nuestros tests de alta, con los datos cambiados por otros inventados (la aplicación, las rutas y los selectores no son los reales):
import customerHelper from '../../support/context/customers/sharedFunctions';

describe('customers - membership sign up', { retries: { runMode: 1, openMode: 0 } }, () => {

    let email;

    before(() => {
        email = `customer-${Date.now()}@example.com`;
    });

    beforeEach(() => {
        cy.visit('/membership');
    });

    afterEach(() => {
        customerHelper.deleteRegisteredCustomer(email);
    });

    ['monthly', 'yearly'].forEach(plan => {
        it(`customer signs up to the ${plan} plan`, () => {
            cy.get(`[data-cy=${plan}PlanButton]`).click();
            cy.url({ timeout: 10000 }).should('contain', `/membership/checkout?plan=${plan}`);

            cy.get('[data-cy=signUpEmail]').type(email);
            cy.get('[data-cy=signUpPassword]').type('a-test-password');
            cy.get('[data-cy=signUpButton]').click();

            cy.url().should('contain', '/membership/welcome');
            customerHelper.checkWelcomeEmailWasSent(email);
        });
    });
});
Y el helper que usa, en support/context/customers/sharedFunctions.js, es el de antes: las consultas viven ahí y el test solo ve el nombre.
function deleteRegisteredCustomer(email) {
    cy.sql(`
        DELETE FROM Memberships
        WHERE CustomerId IN (SELECT Id FROM Customers WHERE Email = @email)`, { email });
    cy.sql('DELETE FROM Customers WHERE Email = @email', { email });
}

// checkWelcomeEmailWasSent: comprueba el buzón de pruebas, con otra tarea de Node

export default { deleteRegisteredCustomer, checkWelcomeEmailWasSent };
Fíjate en tres cosas. La primera: el test ni menciona SQL, y eso es lo que buscábamos. La consulta está dentro de deleteRegisteredCustomer, y quien lee el test solo ve que al terminar se borra el cliente que se acaba de dar de alta. La segunda: el email se genera una sola vez, en el before, y lo comparten todos los tests de la suite (y sus reintentos). Por eso el afterEach es imprescindible: sin él, el segundo plan intentaría darse de alta con un email que ya existe. Y la tercera, que el afterEach también se ejecuta entre los intentos de un test que falla, así que el reintento arranca sin los restos del intento anterior.
La comprobación del email la hacíamos con otra tarea de Node, aparte de la del SQL, que leía el buzón de pruebas. Daría para otro post.
Limpiar antes y después
La limpieza fue lo que más vueltas nos hizo dar. Borrar al final del test lo que ese test ha creado parece lo obvio, pero si el test falla a mitad o la ejecución se corta de golpe (un job de CI cancelado, un Ctrl+C), los datos se quedan ahí.
Lo que hacíamos es lo del test de arriba: un email único por suite y limpieza en afterEach, que se ejecuta aunque el test haya fallado. Y en los tests de compra, además, borrábamos el usuario en el beforeEach: si la ejecución anterior se cortó, el usuario sigue en la base de datos, y el siguiente test arranca limpiando.
Para cerrar
Al principio da un poco de respeto que los tests toquen la base de datos directamente, y es lógico: estás acoplando los tests al esquema. Pero la alternativa es fiarte de que lo que pinta la pantalla es lo que se ha guardado, o ensuciar la aplicación con endpoints solo para los tests. Una conexión, una tarea de Node, un comando cy.sql y un puñado de funciones con buen nombre bastan para que los tests se puedan repetir, para borrar lo que ensucian y para empezar siempre desde un estado conocido. Y si puedes, con la contraseña fuera del repositorio desde el primer día.